
 ## 摘要 机器人走进陌生房间找一个答案最贵的成本不是推理而是走冤枉路。RSS 2024 的《Explore until Confident》简称 Explore-EQA把这件事拆成两个独立问题**往哪走**以及**什么时候停**。 它的做法是给视觉语言模型外挂一张外部语义地图再用**共形预测**校准置信度于是该不该停变成一个带覆盖保证的判据。效果很直接达到 58% 成功率时它只用 71% 的最大时间步而按相关度设阈值的基线要 85%。如果你在做陌生环境里的机器人探索这篇论文的任务拆法与消融设计都能直接借。 **视频讲解**[点击观看 B 站视频](https://www.bilibili.com/video/BV1qcJm62ES3) 章节时间轴 00:35 作者介绍 01:03 研究背景与动机 01:52 相关工作 02:32 方法 03:46 实验设计 04:29 实验结果 06:24 局限性 07:06 要点总结 07:36 参考文献 [TOC] ## 论文基本信息 | 项目 | 内容 | |---|---| | 标题英文 | Explore until Confident: Efficient Exploration for Embodied Question Answering | | 标题中文 | 探索到置信为止面向具身问答的高效主动探索 | | 作者 | Allen Z. Ren、Jaden Clark、Anushri Dixit、Masha Itkina、Anirudha Majumdar、Dorsa Sadigh | | 机构 | Princeton University / Stanford University / Toyota Research Institute | | 会议 | RSS 2024Robotics: Science and Systems | | arXiv | https://arxiv.org/abs/2403.15941 | | 项目网站 | https://explore-eqa.github.io/ | ## 背景与动机 这一节讲清楚机器人为什么要边探索边作答以及之前的做法卡在哪。 先看任务本身。**具身问答**Embodied Question AnsweringEQA指的是机器人从随机位置进入一个陌生的三维场景主动探索最后用自然语言回答问题。论文给的例子很家常——主人让家庭机器人去看看灶台关了没有。 麻烦在于两点。第一场景大且没有先验地图机器人得自己决定往哪走。第二它还得判断信息够不够从而决定什么时候停下来作答。 2023 年之前的主流做法是从零训练探索策略与问答模块。这类方法通常只处理沙发是什么颜色这类简单问题而且集中在合成场景里数据效率不高。 近年的 SQA3D、3D-LLM 改用大模型答题但它们假设信息已经完整——点云或预先采好的图片都摆在那里不需要主动探索。 这篇论文换了个切入点。**视觉语言模型**Vision-Language ModelVLM能同时读图与读文字的模型本身已经具备很强的语义常识问题出在两处它没有空间记忆置信度也没有校准。 所以作者把问题定义成给 VLM 配两个外挂件一张地图负责记忆与方向一套校准机制负责何时收手。论文第一作者 Allen Z. Ren 是 Princeton 的博士导师 Anirudha Majumdar通讯作者还有 Stanford 的 Dorsa Sadigh。团队此前的工作 KnowNo 也是用共形预测只不过判断的是何时向人求助。 ## 研究主线从问题到结论 整篇论文的主线可以压成一张图两个障碍分别对应两个部件最后汇到同一个收益。 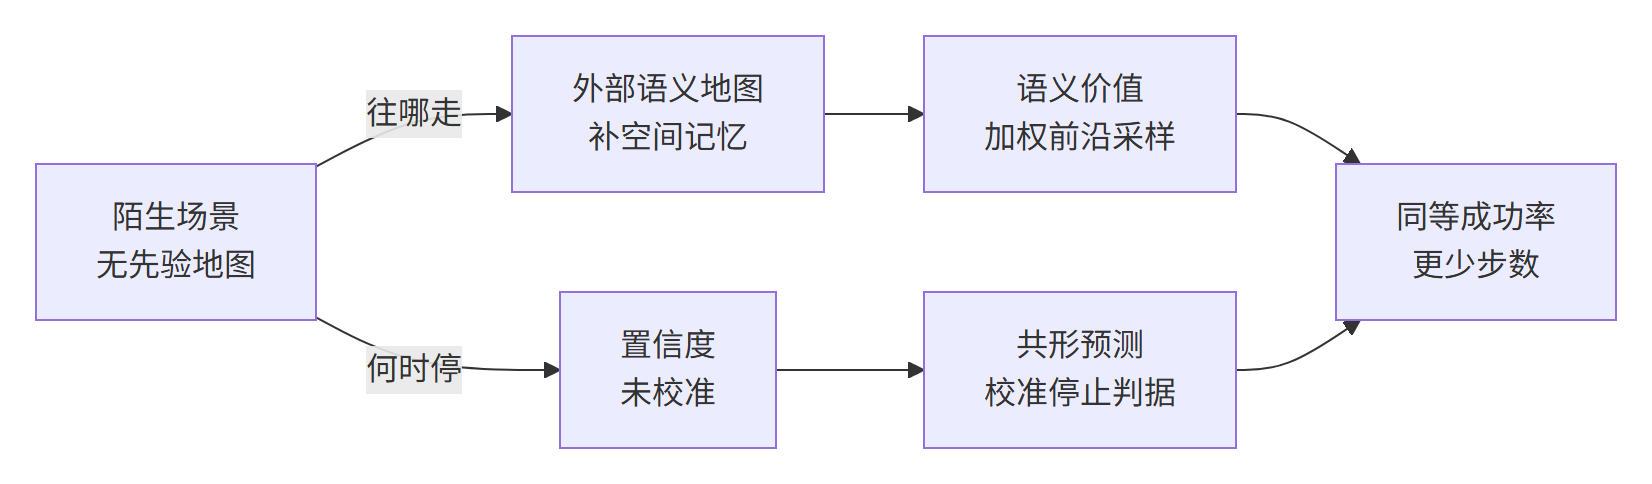 **图 10论文的研究主线。把往哪走交给语义地图把何时停交给共形预测两边合起来换来同等成功率下更少的探索步数。** ## 它要解决的两个具体问题 这一节解释机器人到底会犯什么错以及论文提出的两个对应部件。 第一条障碍是 VLM 没有内部空间记忆。它记不住自己看过哪些区域也记不住还没看但和问题有关的区域在哪。 第二条障碍是 VLM 的置信度没有校准。VLM 由大语言模型微调而来而后者的置信度经常偏高或偏低。 置信度不准会直接换成两种浪费。停得太早会答错停得太晚则多走很多路。论文的实测结果是直接用未校准的分数设阈值机器人两种毛病都会犯。 作者的处理方式是把两个障碍分开外部地图管记忆共形预测管停止。这样模型强不强与会不会及时停就不再纠缠。 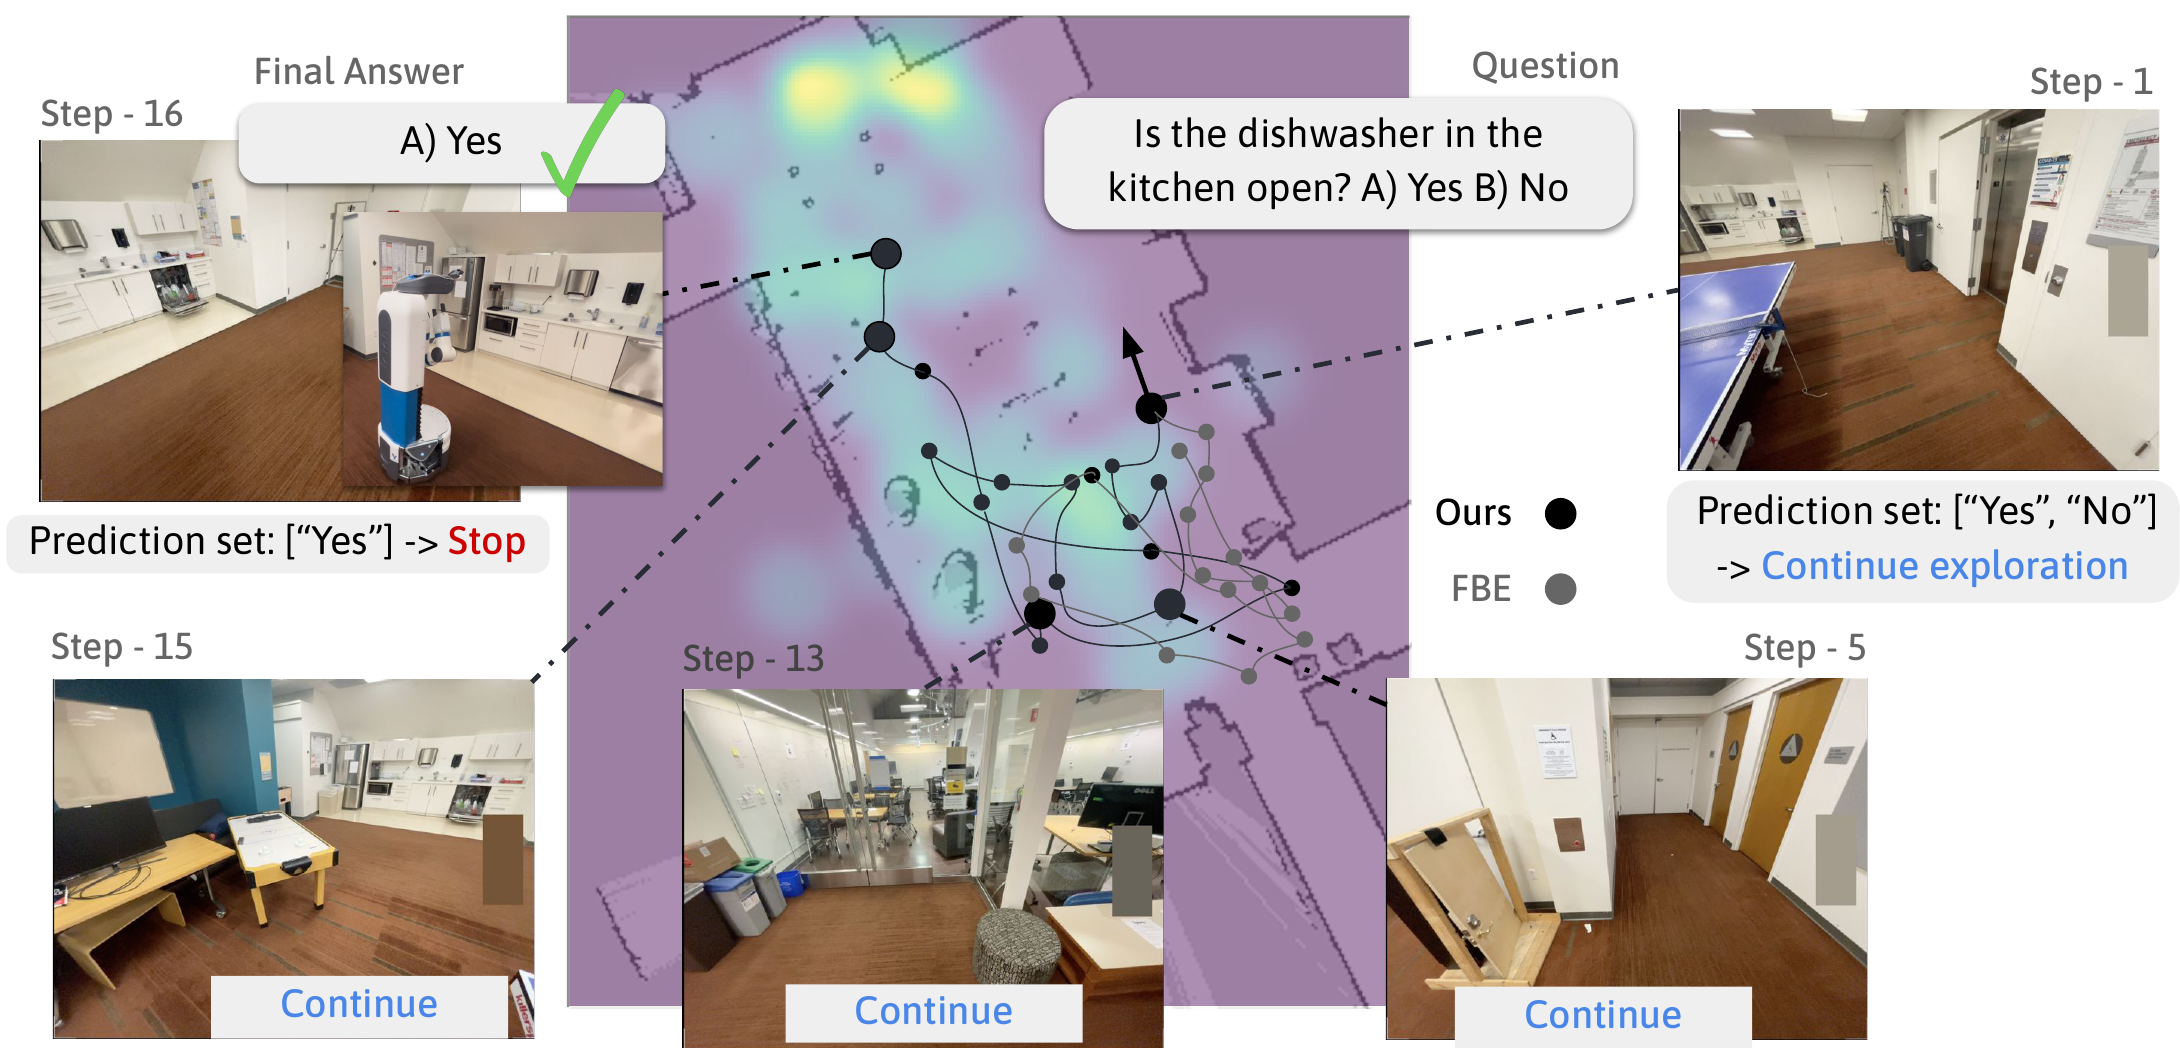 **图 1给定Is the dishwasher in the kitchen open?机器人把 VLM 对当前视角的语义判断叠加到占据地图上优先走向相关区域候选答案集合缩到唯一答案就停止。本例在第 16 步停下此时洗碗机已经进入视野。** ## 分类全景 这一节把机器人当前面对的不确定性分成两类并列出各自对应的部件。 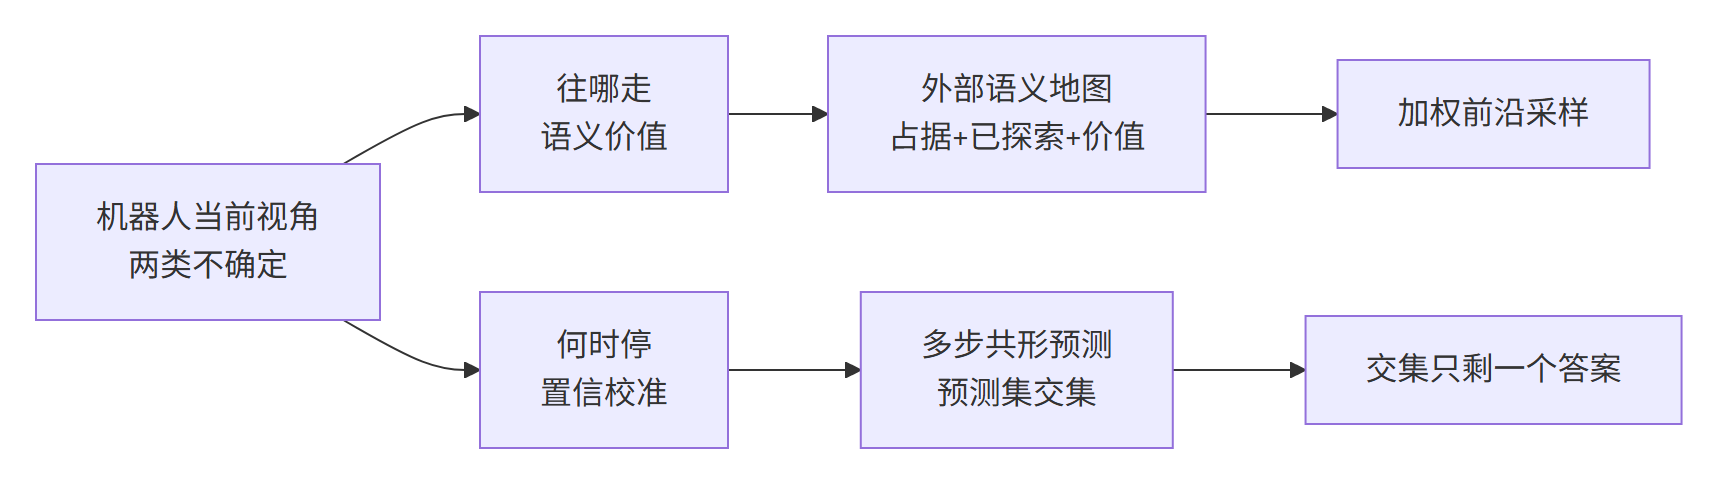 **图 11两类不确定性及其对应部件。方向由语义价值加权的场景地图决定停止由共形预测的预测集交集决定。** ## 方法细节 这一节把方法的四个环节讲完语义价值怎么算、地图怎么维护、下一步怎么选、什么时候收手。 语义价值分两层。**局部语义价值**LSV的做法是把当前视角里的自由空间用最远点采样挑出 3 个点在图上标上 A、B、C再提示 VLM取它对每个方向的概率。它回答的是眼前哪一块更值得去。 **全局语义价值**GSV再问一次 VLM这个视角里是否存在值得探索的方向。取它回答 Yes 的概率回答的是值不值得走过去。 两者用温度缩放后取指数组合成整体语义价值$\text{SV}_p\exp(\tau_{\text{LSV}}\text{LSV}_p\tau_{\text{GSV}}\text{GSV}_p)$。 地图这边机器人用截断符号距离函数TSDF融合维护体素地图高度固定 3.5 米相机高度 1.5 米以下判定为自由空间。还有个小设计只有更小视野内的体素才算已探索水平视场角的中间一半、垂直视场角的下半部分才算数。这样探索粒度更细。 选下一个位置时论文沿用了前沿探索Frontier-Based Exploration的框架只是在采样权重里乘上语义价值$w_p\exp(\tau_{\text{SV}}\text{SV}_p\tau_{\text{SV,N}}\text{SV}_{p,\text{normal}})$。其中第二项是沿法向 3 米范围内的平均语义价值它让机器人朝相关区域的方向走而不只是挑眼前最亮的点。 停止判据是全文最核心的一步。论文先定义非一致性分数 $\rho_y(x)\text{Rel}(x)(\hat{f}_y(x)-1)$也就是用问题-图像相关度去加权答案概率。再在 300 个校准场景上取经验分位数作为阈值 $\hat{q}$。每一步都能构造一个预测集 $C_t$只包含那些分数不低于 $1-\hat{q}$ 的答案机器人维护所有预测集的交集 $\bigcap_t C_t$交集只剩一个答案时就停下。 这样做的价值在于保证以概率 $1-\epsilon$真实答案始终留在交集里。停下来的那一刻答案正确的概率就有了量化下界而不是靠感觉够了。 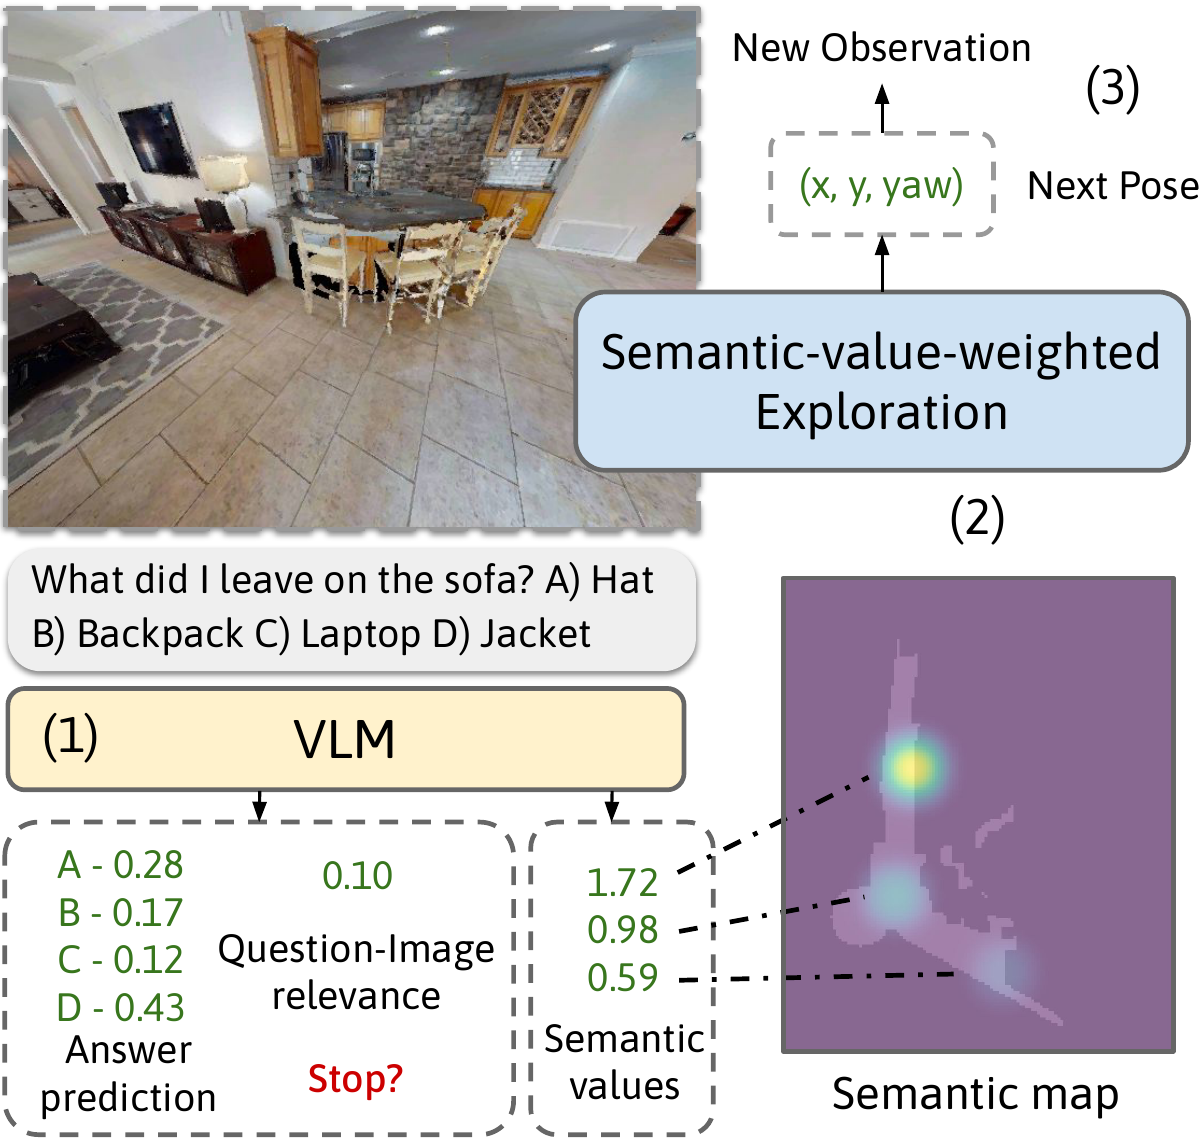 **图 2框架总览。VLM 提供答案概率、问题-图像相关度与语义价值语义价值写入外部地图规划器按它加权采样下一个前沿点。** ## 实验设计与结果 这一节先交代数据与协议再给结果。 仿真部分论文贡献了 **HM-EQA** 数据集基于 HM3D 的真实室内扫描共 500 个场景。问题由 GPT4-V 依据 12 个随机视角生成再由人工删掉过简单或幻觉物体的问题。任务统一为四选一。 题目分布覆盖五类占比合计 100% | 问题类别 | 占比 | 论文里的例子 | |---|---|---| | Location | 26.0% | 黑色行李箱放在哪 | | Existence | 21.6% | 夹克是不是落在门口长凳上 | | State | 20.2% | 客厅的空调是不是开着 | | Identification | 16.2% | 餐桌上铺的是哪块桌布 | | Counting | 16.0% | 台球桌上还剩几根球杆 | 真机部分用 Fetch 移动机器人加一台 iPhone 12 广角相机测 6 个场景3 个家居/办公环境各 2 组问答。 评测把两个问题拆开。探索实验让机器人跑满最大步数看归一化步数对成功率的曲线用全部 500 个场景。停止实验则用 300 个场景校准、200 个场景测试分别扫描阈值。这个拆分很重要它让往哪走和何时停的贡献可以分别归因。 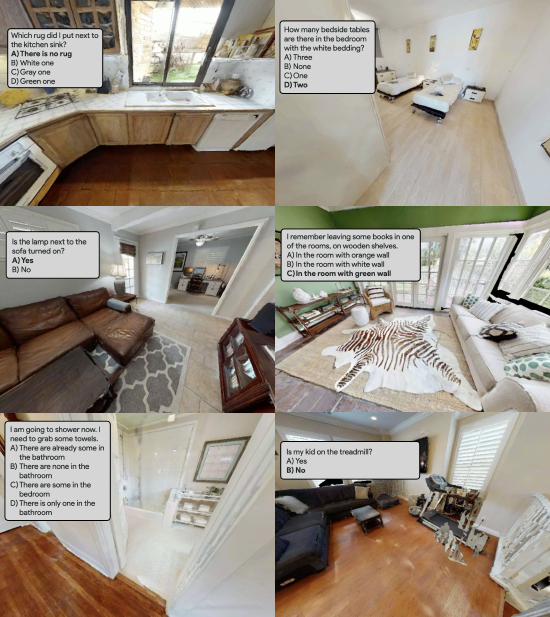 **图 3HM-EQA 的样例场景。图中是机器人给出最终答案时使用的视角方框内是问题与加粗的真值答案问题贴近日常家居场景需要语义推理。** 探索侧的结果是相比纯前沿探索FBE和用 CLIP 打分的语义前沿探索CLIP-FBE论文方法用更少的步数达到同样的成功率。差距在最大步数的 20% 到 30% 阶段最明显说明它一开始就走对了方向。 消融说明了两个语义价值都不能省。去掉 GSV 会变得近视早期成功率看起来更高之后却停滞机器人困在错误的选点上。去掉 LSV 则语义粒度变粗整体效率下降。两者单独去掉都会掉到 FBE 的水平甚至更差。 温度缩放也有甜点。论文扫了 $\tau_{\text{LSV}},\tau_{\text{GSV}}\in\{1,3,5\}$太大时早期快、后期差因为过度相信了并不总是可靠的 VLM 推理太小时效率又不够。 停止侧的结果更能说明校准的价值 | 停止准则 | 判断依据 | 达到 58% 成功率所需步数 | |---|---|---| | Entropy | 答案预测熵低于阈值 | 达不到过早停止 | | Relevance | 问题-图像相关度高于阈值 | 85% | | Ours | 多步共形预测的预测集交集 | 71% | 熵基线失手的原因值得一提。机器人常常面对与问题无关的视角而 VLM 在这些视角上依然给出高置信的错误答案于是预测熵很低机器人提前收工。 相关度阈值虽然能用但代价是步数。论文的读法是没有校准的分数会让机器人过度探索。 模型的强弱也会直接反映到结果上。同一套框架换成 LLaVA 1.6最大步数下的成功率从 58.4% 升到 65.3%把 300 个场景拿来微调 VLM成功率则从 56.2% 升到 68.1%。 | 设置 | 最大步数下的成功率 | |---|---| | Prismatic VLM主实验 | 58.4% | | LLaVA 1.6同框架换模型 | 65.3% | | Prismatic 300 场景微调 | 68.1%微调前 56.2% | 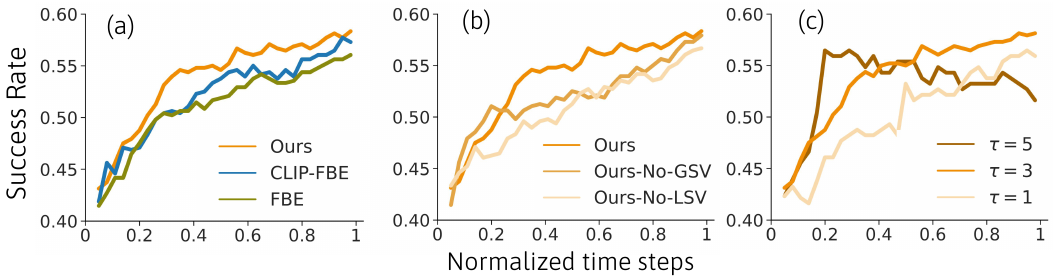 **图 4归一化时间步对成功率仿真。(a) 不同探索方法对比(b) 去掉 GSV/LSV 的消融(c) 语义价值温度缩放的扫描。** 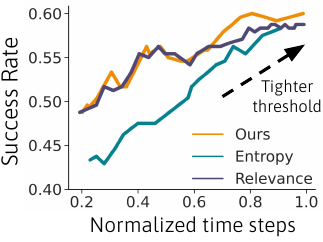 **图 5停止准则的阈值扫描。本文的置信水平从 0.27 扫到 0.99问答熵阈值从 0.08 到 0.001相关度阈值从 0.1 到 0.99。** 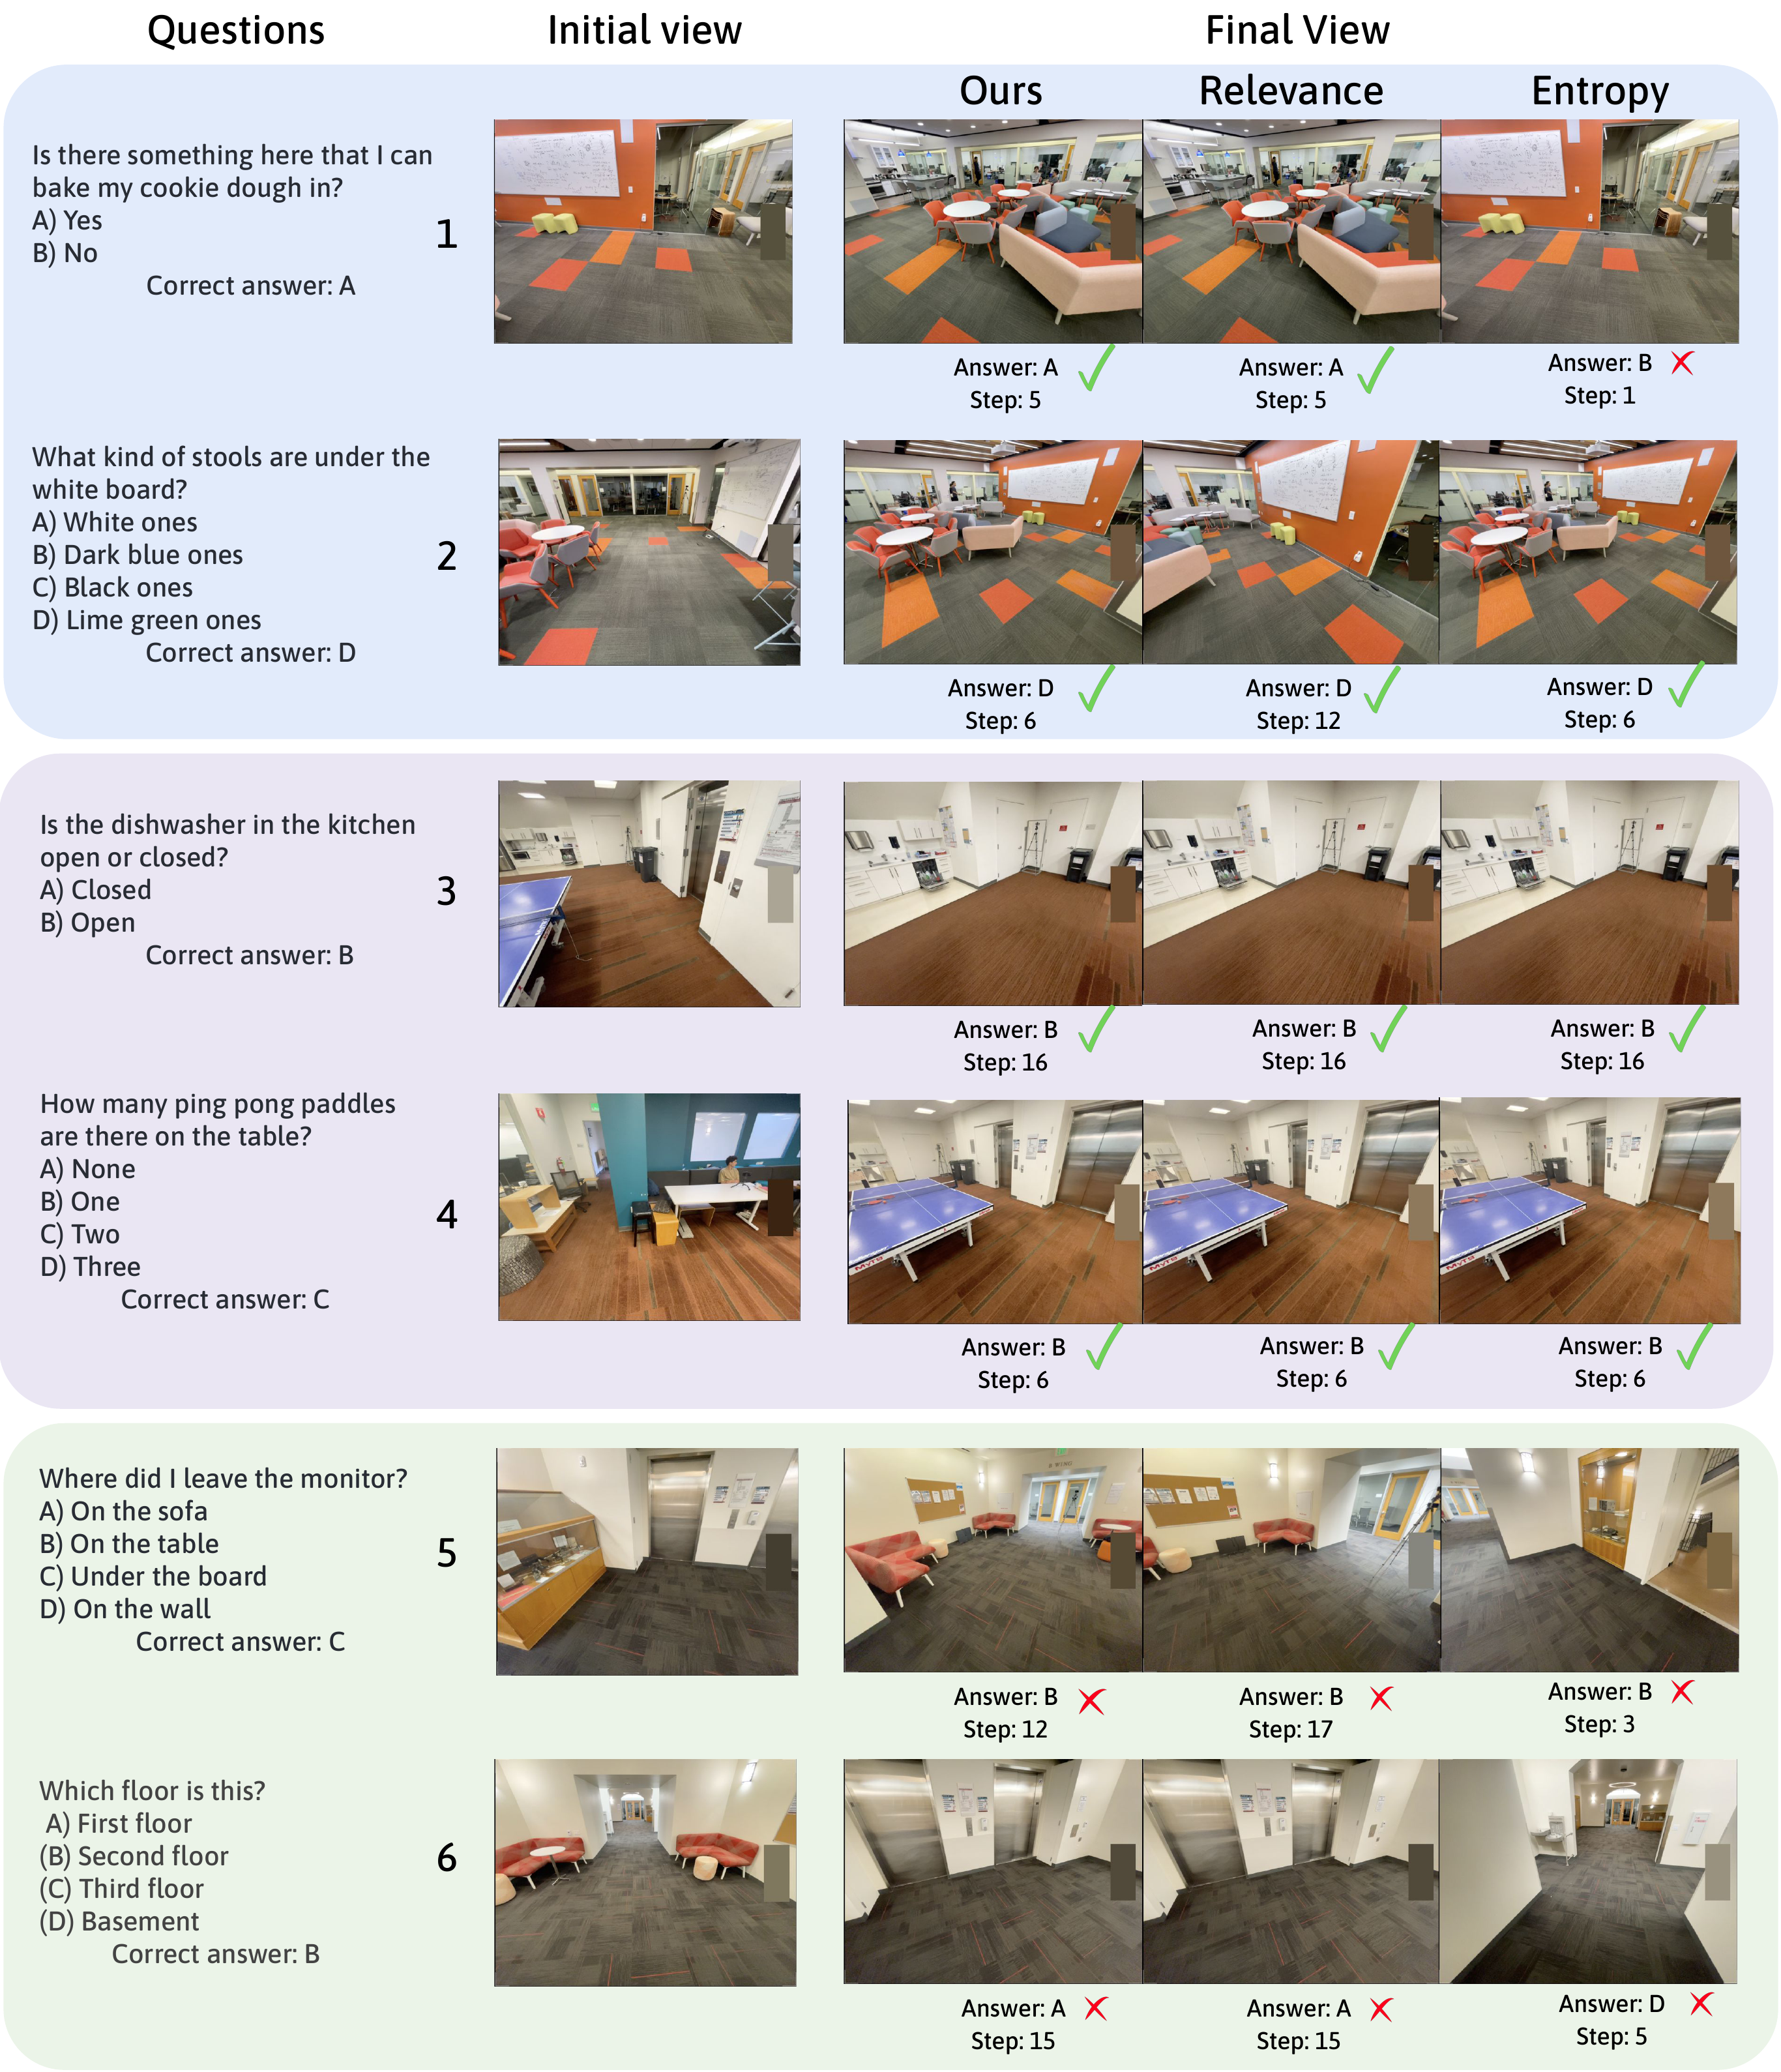 **图 6真机的六个场景。图中给出问题与答案、初始视角、各方法停止后的最终视角、最终答案与停止步数。** 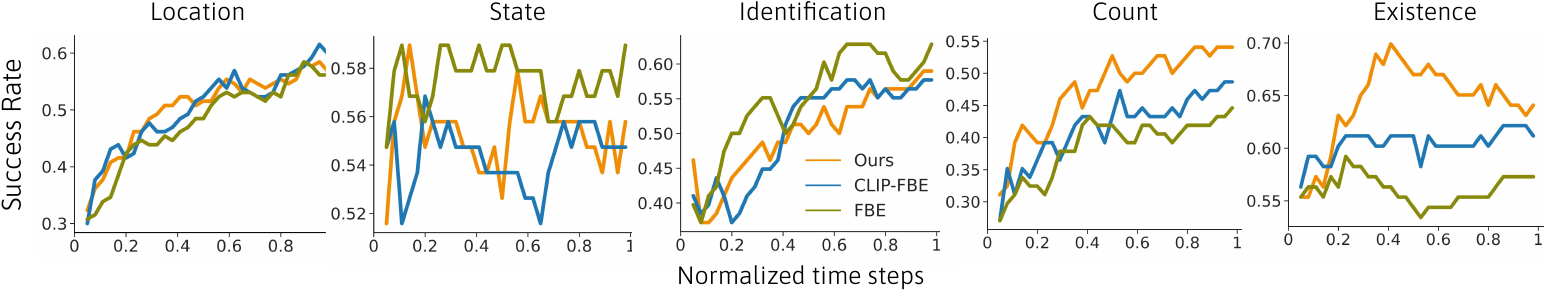 **图 7按五类问题分别统计的结果。论文方法在计数与存在性两类问题上的提升最明显因为这两类问题本身就透露了目标位置信息。** 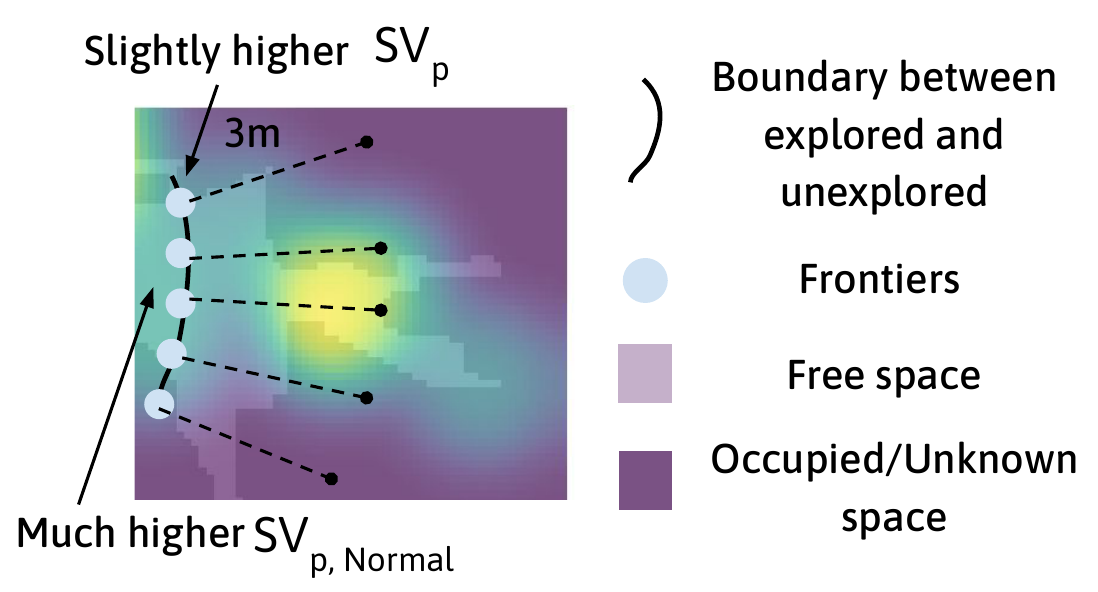 **图 8前沿点权重同时取决于该点自身的语义价值以及沿法向 3 米范围内的平均语义价值。** 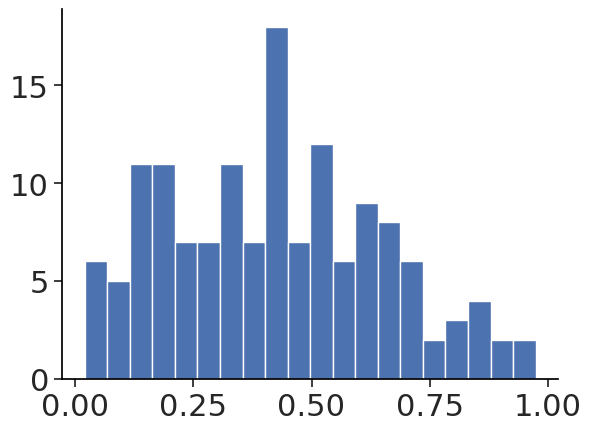 **图 9每个成功场景中最高相关度分数的直方图。大量场景的最高分低于 0.5说明原始相关度并不能反映是否足以作答。** 真机部分聚焦停止准则。阈值按仿真中约 50% 成功率的水平选取本文的置信参数取 0.5相关度取 0.4熵取 0.1。论文方法与相关度基线都在 6 个场景里答对 4 个但相关度基线在其中两个场景多花了步数熵基线则因为早停在一个场景答错。 ## 结果对比总结 这一节把三类停止准则的对比收成一张图。 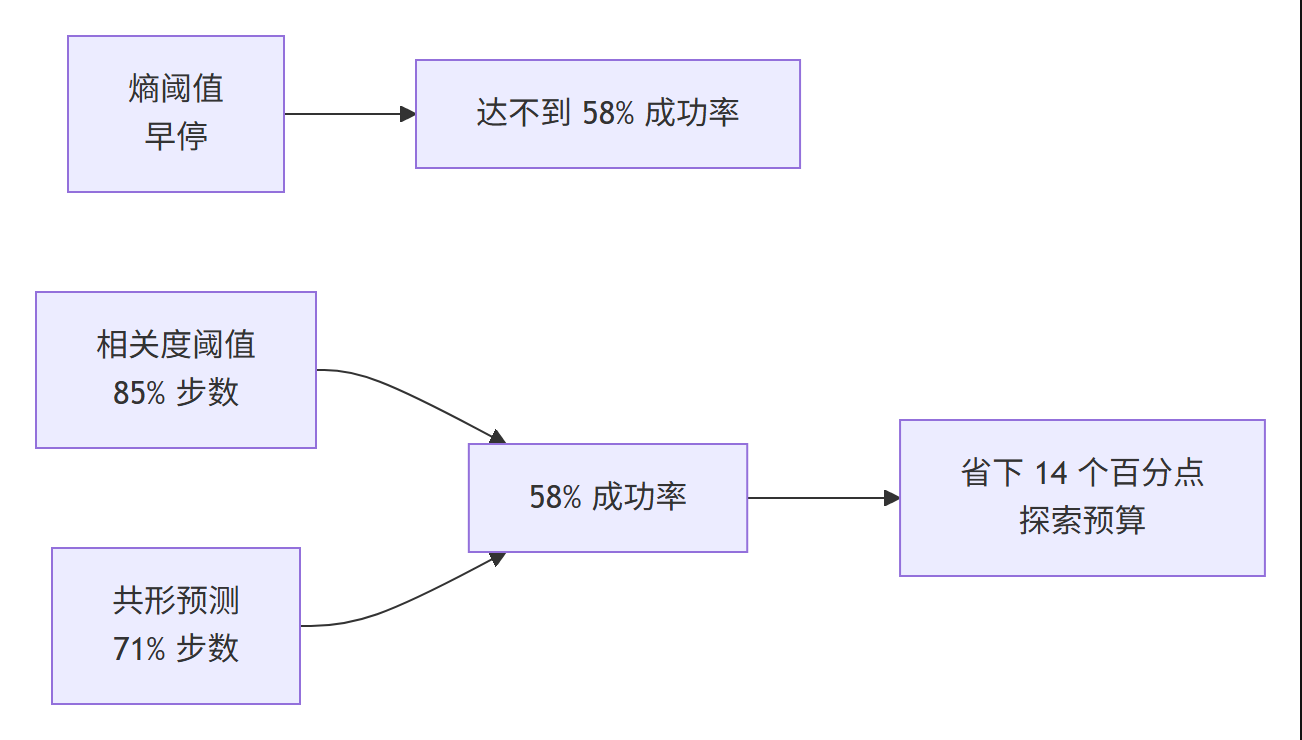 **图 12三类停止准则的对比。带覆盖保证的校准让机器人更早停下同时不牺牲成功率。** ## 关键发现 - 达到 58% 成功率时论文方法只用 **71%** 的最大时间步而基于相关度阈值的基线要 **85%**。这 14 个百分点全部来自校准。 - HM-EQA 覆盖 **500** 个仿真场景与 **6** 个真机场景停止实验用 **300** 个场景校准、**200** 个场景测试。 - 两个语义价值缺一不可去掉 GSV 会变近视早期虚高、后期停滞去掉 LSV 则语义粒度变粗两者都会掉到 FBE 水平。 - 温度缩放的甜点在中间论文扫了 **1、3、5**过高早期快但后期差过低效率不足。 - 框架与模型能力解耦换成 LLaVA 1.6 后成功率从 **58.4%** 升到 **65.3%**微调 VLM 后到 **68.1%**。 - 失败主要来自 VLM 本身跑满步数也只有约 **60%**多数错例是机器人已经看到相关物体、但模型答错了。 ## 值得借鉴的创新模式与写法 这一节换个角度看它从写作与创新模式上这篇论文有哪些套路值得抄。 先看创新模式。如果按顶会论文总结出的 15 种模式来对它命中三条。 第一条是把问题重述成一个可求解的对象。原来的做法是给答案熵或相关度设一个阈值全靠手调论文把何时停改成共形预测的预测集交集于是停止时刻带上了概率意义。 第二条是用消融把混淆因素拆开测。去掉 GSV、去掉 LSV 两组对照把语义引导有没有用和停止准则有没有用分成两个独立命题读者不用猜。 第三条是靠条件化适配而不是重训练。VLM 权重不动适配发生在地图与提示层所以换模型就能直接涨点。 再看叙事与措辞。论文开头用了一个具体场景服务机器人被派到家里主人让它确认灶台是否关闭。接着用一句反问把两个障碍立成研究问题。最后用仿真与真机实验的并置来兑现承诺。 措辞上也有几处可学讲证据时直接说仿真与真机实验都表明而不是铺形容词讲新颖性时用对照句例如我们的方法直接使用 VLM 的概率输出不需要额外训练。 当然源码里也留了些小瑕疵值得一提有两处语法笔误a scalar quantify、Each weight are一个拼错的标签名以及两处 hedge 写法We believe that…、We envision that…。这些不影响结论但对想学写作的人是个提醒。 ## 局限性 这部分内容来自论文的讨论与附录我按重要性排一下。 第一语义价值只看位置、不看朝向。同一个位置从背面可能因为遮挡而看不见论文目前只能靠小步走、从多个朝向观察来缓解。 第二方法上限受限于开源 VLM 的空间推理能力失败大多源于模型自己答错。作者也承认当前模型在不同场景之间的一致性还不够。 第三问题形式被限制在四选一。不足四个选项时要补一个占位选项比如D) 请不要选这一项。开放问答需要额外的候选生成步骤。 第四评测条件偏理想仿真假设完美里程计最大步数由场景二维面积开方乘三给定。真实部署里的定位漂移会直接吃掉探索预算。 作者给出的下一步包括用仿真场景或自我中心人类数据例如 Ego4D训练模型预测探索方向把多视角输入与检索引入推理以及把共形预测的预测集反过来用于引导探索——集合本身就给出了候选位置。 ## 常见问题FAQ ### 我要复现它大概需要什么资源 论文没有给出训练侧的资源明细因为主实验不训练 VLM。仿真实验在 Habitat 里跑 HM-EQA 的 500 个场景VLM 用的是开源的 Prismatic真机是单台 Fetch 加一部 iPhone 12。复现的主要成本在仿真渲染与推理侧的调用量。 ### 它和 KnowNo 有什么关系 同一批作者的前序工作是 KnowNo同样用共形预测校准大模型的不确定性。区别在判断对象KnowNo 判断规划器何时该向人类求助本文判断机器人何时该停止探索。 ### 它和 CLIP 类语义导航的区别在哪 CLIP-FBE 用 CLIP 给场景打分做语义权重论文方法则直接用 VLM 的概率输出。论文的观察是 CLIP 偏向词袋式匹配遇到走廊尽头那扇门后是什么这类需要推理的问题给出的信号会变弱。 ### 共形预测的覆盖保证在实际使用中怎么读 它保证的是以概率 $1-\epsilon$真实答案留在预测集交集里。这个说法依赖校准场景与测试场景同分布论文里用 300 个场景校准、200 个场景测试来满足这一点。 ### 为什么不用 GPT4-V 做实验 因为方法需要模型输出概率而当时可用的 GPT4-V 接口拿不到 log 概率。论文因此选了开源的 Prismatic附录里也提到官方版 GPT4-V 后来开放了 log 概率。 ## 最后一句 这篇论文最值得带走的一句话是具身探索的两个死结——记不住、停不准——可以用一张地图和一套校准解开而不必等一个更大的模型。如果你顺着这条线往下看建议优先读后续把记忆与信念建模引入 EQA 的工作例如 Memory-Centric EQA 与 Prune-Then-Plan它们处理的正是本文偏理想化的那部分假设。 ## 参考链接 - 论文 arXiv 主页https://arxiv.org/abs/2403.15941 - 项目主页与实验视频https://explore-eqa.github.io/ - EQA 起点工作 EmbodiedQADas et al., CVPR 2018https://arxiv.org/abs/1711.11543 - 共形预测入门Angelopoulos Bateshttps://arxiv.org/abs/2107.07511 - 前序工作 KnowNoRen et al., 2023https://arxiv.org/abs/2307.01928 --- 给大家推荐一款自用写文献综述、无虚构文献的 AI **复旦大学 FudanNLP 团队自研 [切问学术](https://qiewenpaper.com/zh?utm_sourcebzkolutm_contentbaishi)** 官网[qiewenpaper.com](https://qiewenpaper.com/zh?utm_sourcebzkolutm_contentbaishi) 覆盖 **3.6 亿篇**可溯源真实中英文文献能自动整合文献观点生成规范综述 还能挖掘研究创新点、复现实验配合视频教学新手快速上手文献综述写作 --- **后记** 博客的关键词集中在编程、算法、机器人、人工智能、数学等等持续高质量输出中。 **讨论QQ群**[白拾的小屋](https://qun.qq.com/universal-share/share?ac1authKeySuzrb5NKb9KulvZxFC8EMFvcd6jgVp%2B%2BnTG8h351HWQorXVfvI1n5QwEX5dlJyThbusi_dataeyJncm91cENvZGUiOiI3NTAzNjU3MDAiLCJ0b2tlbiI6IlpFL2xLaGYxdXU4cWJPT2dJTkY3aExnWHNaQ1UrL3NJbWprenhLZitWUHVVNmhIR1M5SkZrS09SWmxKNlRreksiLCJ1aW4iOiIyMjc1OTYwNDg2In0%3DdatahgymRnqgtjQPGoBKhZ8cEyznp0CMLWfCbG4rfiWIADCArVXw50a7c-Q4MWU2Eq3dwOUjG19hamAWQQU4lY-cOQsvctype4tempidh5_group_info) (750365700) **⭐B站账号**[白拾的物理AI组会](https://space.bilibili.com/98639326)活跃于知识区和动画区 **✨GitHub主页**[YhbCode000](https://github.com/yhbcode000)工程文件
 长河君 · 2026/10/17 6:53:43 · 阅读 1.2k
【RSS 2024】Explore-EQA:探索到置信为止,面向具身问答的高效主动探索|从具身智能主动感知视角
## 摘要 机器人走进陌生房间找一个答案最贵的成本不是推理而是走冤枉路。RSS 2024 的《Explore until Confident》简称 Explore-EQA把这件事拆成两个独立问题**往哪走**以及**什么时候停**。 它的做法是给视觉语言模型外挂一张外部语义地图再用**共形预测**校准置信度于是该不该停变成一个带覆盖保证的判据。效果很直接达到 58% 成功率时它只用 71% 的最大时间步而按相关度设阈值的基线要 85%。如果你在做陌生环境里的机器人探索这篇论文的任务拆法与消融设计都能直接借。 **视频讲解**[点击观看 B 站视频](https://www.bilibili.com/video/BV1qcJm62ES3) 章节时间轴 00:35 作者介绍 01:03 研究背景与动机 01:52 相关工作 02:32 方法 03:46 实验设计 04:29 实验结果 06:24 局限性 07:06 要点总结 07:36 参考文献 [TOC] ## 论文基本信息 | 项目 | 内容 | |---|---| | 标题英文 | Explore until Confident: Efficient Exploration for Embodied Question Answering | | 标题中文 | 探索到置信为止面向具身问答的高效主动探索 | | 作者 | Allen Z. Ren、Jaden Clark、Anushri Dixit、Masha Itkina、Anirudha Majumdar、Dorsa Sadigh | | 机构 | Princeton University / Stanford University / Toyota Research Institute | | 会议 | RSS 2024Robotics: Science and Systems | | arXiv | https://arxiv.org/abs/2403.15941 | | 项目网站 | https://explore-eqa.github.io/ | ## 背景与动机 这一节讲清楚机器人为什么要边探索边作答以及之前的做法卡在哪。 先看任务本身。**具身问答**Embodied Question AnsweringEQA指的是机器人从随机位置进入一个陌生的三维场景主动探索最后用自然语言回答问题。论文给的例子很家常——主人让家庭机器人去看看灶台关了没有。 麻烦在于两点。第一场景大且没有先验地图机器人得自己决定往哪走。第二它还得判断信息够不够从而决定什么时候停下来作答。 2023 年之前的主流做法是从零训练探索策略与问答模块。这类方法通常只处理沙发是什么颜色这类简单问题而且集中在合成场景里数据效率不高。 近年的 SQA3D、3D-LLM 改用大模型答题但它们假设信息已经完整——点云或预先采好的图片都摆在那里不需要主动探索。 这篇论文换了个切入点。**视觉语言模型**Vision-Language ModelVLM能同时读图与读文字的模型本身已经具备很强的语义常识问题出在两处它没有空间记忆置信度也没有校准。 所以作者把问题定义成给 VLM 配两个外挂件一张地图负责记忆与方向一套校准机制负责何时收手。论文第一作者 Allen Z. Ren 是 Princeton 的博士导师 Anirudha Majumdar通讯作者还有 Stanford 的 Dorsa Sadigh。团队此前的工作 KnowNo 也是用共形预测只不过判断的是何时向人求助。 ## 研究主线从问题到结论 整篇论文的主线可以压成一张图两个障碍分别对应两个部件最后汇到同一个收益。  **图 10论文的研究主线。把往哪走交给语义地图把何时停交给共形预测两边合起来换来同等成功率下更少的探索步数。** ## 它要解决的两个具体问题 这一节解释机器人到底会犯什么错以及论文提出的两个对应部件。 第一条障碍是 VLM 没有内部空间记忆。它记不住自己看过哪些区域也记不住还没看但和问题有关的区域在哪。 第二条障碍是 VLM 的置信度没有校准。VLM 由大语言模型微调而来而后者的置信度经常偏高或偏低。 置信度不准会直接换成两种浪费。停得太早会答错停得太晚则多走很多路。论文的实测结果是直接用未校准的分数设阈值机器人两种毛病都会犯。 作者的处理方式是把两个障碍分开外部地图管记忆共形预测管停止。这样模型强不强与会不会及时停就不再纠缠。  **图 1给定Is the dishwasher in the kitchen open?机器人把 VLM 对当前视角的语义判断叠加到占据地图上优先走向相关区域候选答案集合缩到唯一答案就停止。本例在第 16 步停下此时洗碗机已经进入视野。** ## 分类全景 这一节把机器人当前面对的不确定性分成两类并列出各自对应的部件。  **图 11两类不确定性及其对应部件。方向由语义价值加权的场景地图决定停止由共形预测的预测集交集决定。** ## 方法细节 这一节把方法的四个环节讲完语义价值怎么算、地图怎么维护、下一步怎么选、什么时候收手。 语义价值分两层。**局部语义价值**LSV的做法是把当前视角里的自由空间用最远点采样挑出 3 个点在图上标上 A、B、C再提示 VLM取它对每个方向的概率。它回答的是眼前哪一块更值得去。 **全局语义价值**GSV再问一次 VLM这个视角里是否存在值得探索的方向。取它回答 Yes 的概率回答的是值不值得走过去。 两者用温度缩放后取指数组合成整体语义价值$\text{SV}_p\exp(\tau_{\text{LSV}}\text{LSV}_p\tau_{\text{GSV}}\text{GSV}_p)$。 地图这边机器人用截断符号距离函数TSDF融合维护体素地图高度固定 3.5 米相机高度 1.5 米以下判定为自由空间。还有个小设计只有更小视野内的体素才算已探索水平视场角的中间一半、垂直视场角的下半部分才算数。这样探索粒度更细。 选下一个位置时论文沿用了前沿探索Frontier-Based Exploration的框架只是在采样权重里乘上语义价值$w_p\exp(\tau_{\text{SV}}\text{SV}_p\tau_{\text{SV,N}}\text{SV}_{p,\text{normal}})$。其中第二项是沿法向 3 米范围内的平均语义价值它让机器人朝相关区域的方向走而不只是挑眼前最亮的点。 停止判据是全文最核心的一步。论文先定义非一致性分数 $\rho_y(x)\text{Rel}(x)(\hat{f}_y(x)-1)$也就是用问题-图像相关度去加权答案概率。再在 300 个校准场景上取经验分位数作为阈值 $\hat{q}$。每一步都能构造一个预测集 $C_t$只包含那些分数不低于 $1-\hat{q}$ 的答案机器人维护所有预测集的交集 $\bigcap_t C_t$交集只剩一个答案时就停下。 这样做的价值在于保证以概率 $1-\epsilon$真实答案始终留在交集里。停下来的那一刻答案正确的概率就有了量化下界而不是靠感觉够了。  **图 2框架总览。VLM 提供答案概率、问题-图像相关度与语义价值语义价值写入外部地图规划器按它加权采样下一个前沿点。** ## 实验设计与结果 这一节先交代数据与协议再给结果。 仿真部分论文贡献了 **HM-EQA** 数据集基于 HM3D 的真实室内扫描共 500 个场景。问题由 GPT4-V 依据 12 个随机视角生成再由人工删掉过简单或幻觉物体的问题。任务统一为四选一。 题目分布覆盖五类占比合计 100% | 问题类别 | 占比 | 论文里的例子 | |---|---|---| | Location | 26.0% | 黑色行李箱放在哪 | | Existence | 21.6% | 夹克是不是落在门口长凳上 | | State | 20.2% | 客厅的空调是不是开着 | | Identification | 16.2% | 餐桌上铺的是哪块桌布 | | Counting | 16.0% | 台球桌上还剩几根球杆 | 真机部分用 Fetch 移动机器人加一台 iPhone 12 广角相机测 6 个场景3 个家居/办公环境各 2 组问答。 评测把两个问题拆开。探索实验让机器人跑满最大步数看归一化步数对成功率的曲线用全部 500 个场景。停止实验则用 300 个场景校准、200 个场景测试分别扫描阈值。这个拆分很重要它让往哪走和何时停的贡献可以分别归因。  **图 3HM-EQA 的样例场景。图中是机器人给出最终答案时使用的视角方框内是问题与加粗的真值答案问题贴近日常家居场景需要语义推理。** 探索侧的结果是相比纯前沿探索FBE和用 CLIP 打分的语义前沿探索CLIP-FBE论文方法用更少的步数达到同样的成功率。差距在最大步数的 20% 到 30% 阶段最明显说明它一开始就走对了方向。 消融说明了两个语义价值都不能省。去掉 GSV 会变得近视早期成功率看起来更高之后却停滞机器人困在错误的选点上。去掉 LSV 则语义粒度变粗整体效率下降。两者单独去掉都会掉到 FBE 的水平甚至更差。 温度缩放也有甜点。论文扫了 $\tau_{\text{LSV}},\tau_{\text{GSV}}\in\{1,3,5\}$太大时早期快、后期差因为过度相信了并不总是可靠的 VLM 推理太小时效率又不够。 停止侧的结果更能说明校准的价值 | 停止准则 | 判断依据 | 达到 58% 成功率所需步数 | |---|---|---| | Entropy | 答案预测熵低于阈值 | 达不到过早停止 | | Relevance | 问题-图像相关度高于阈值 | 85% | | Ours | 多步共形预测的预测集交集 | 71% | 熵基线失手的原因值得一提。机器人常常面对与问题无关的视角而 VLM 在这些视角上依然给出高置信的错误答案于是预测熵很低机器人提前收工。 相关度阈值虽然能用但代价是步数。论文的读法是没有校准的分数会让机器人过度探索。 模型的强弱也会直接反映到结果上。同一套框架换成 LLaVA 1.6最大步数下的成功率从 58.4% 升到 65.3%把 300 个场景拿来微调 VLM成功率则从 56.2% 升到 68.1%。 | 设置 | 最大步数下的成功率 | |---|---| | Prismatic VLM主实验 | 58.4% | | LLaVA 1.6同框架换模型 | 65.3% | | Prismatic 300 场景微调 | 68.1%微调前 56.2% |  **图 4归一化时间步对成功率仿真。(a) 不同探索方法对比(b) 去掉 GSV/LSV 的消融(c) 语义价值温度缩放的扫描。**  **图 5停止准则的阈值扫描。本文的置信水平从 0.27 扫到 0.99问答熵阈值从 0.08 到 0.001相关度阈值从 0.1 到 0.99。**  **图 6真机的六个场景。图中给出问题与答案、初始视角、各方法停止后的最终视角、最终答案与停止步数。**  **图 7按五类问题分别统计的结果。论文方法在计数与存在性两类问题上的提升最明显因为这两类问题本身就透露了目标位置信息。**  **图 8前沿点权重同时取决于该点自身的语义价值以及沿法向 3 米范围内的平均语义价值。**  **图 9每个成功场景中最高相关度分数的直方图。大量场景的最高分低于 0.5说明原始相关度并不能反映是否足以作答。** 真机部分聚焦停止准则。阈值按仿真中约 50% 成功率的水平选取本文的置信参数取 0.5相关度取 0.4熵取 0.1。论文方法与相关度基线都在 6 个场景里答对 4 个但相关度基线在其中两个场景多花了步数熵基线则因为早停在一个场景答错。 ## 结果对比总结 这一节把三类停止准则的对比收成一张图。  **图 12三类停止准则的对比。带覆盖保证的校准让机器人更早停下同时不牺牲成功率。** ## 关键发现 - 达到 58% 成功率时论文方法只用 **71%** 的最大时间步而基于相关度阈值的基线要 **85%**。这 14 个百分点全部来自校准。 - HM-EQA 覆盖 **500** 个仿真场景与 **6** 个真机场景停止实验用 **300** 个场景校准、**200** 个场景测试。 - 两个语义价值缺一不可去掉 GSV 会变近视早期虚高、后期停滞去掉 LSV 则语义粒度变粗两者都会掉到 FBE 水平。 - 温度缩放的甜点在中间论文扫了 **1、3、5**过高早期快但后期差过低效率不足。 - 框架与模型能力解耦换成 LLaVA 1.6 后成功率从 **58.4%** 升到 **65.3%**微调 VLM 后到 **68.1%**。 - 失败主要来自 VLM 本身跑满步数也只有约 **60%**多数错例是机器人已经看到相关物体、但模型答错了。 ## 值得借鉴的创新模式与写法 这一节换个角度看它从写作与创新模式上这篇论文有哪些套路值得抄。 先看创新模式。如果按顶会论文总结出的 15 种模式来对它命中三条。 第一条是把问题重述成一个可求解的对象。原来的做法是给答案熵或相关度设一个阈值全靠手调论文把何时停改成共形预测的预测集交集于是停止时刻带上了概率意义。 第二条是用消融把混淆因素拆开测。去掉 GSV、去掉 LSV 两组对照把语义引导有没有用和停止准则有没有用分成两个独立命题读者不用猜。 第三条是靠条件化适配而不是重训练。VLM 权重不动适配发生在地图与提示层所以换模型就能直接涨点。 再看叙事与措辞。论文开头用了一个具体场景服务机器人被派到家里主人让它确认灶台是否关闭。接着用一句反问把两个障碍立成研究问题。最后用仿真与真机实验的并置来兑现承诺。 措辞上也有几处可学讲证据时直接说仿真与真机实验都表明而不是铺形容词讲新颖性时用对照句例如我们的方法直接使用 VLM 的概率输出不需要额外训练。 当然源码里也留了些小瑕疵值得一提有两处语法笔误a scalar quantify、Each weight are一个拼错的标签名以及两处 hedge 写法We believe that…、We envision that…。这些不影响结论但对想学写作的人是个提醒。 ## 局限性 这部分内容来自论文的讨论与附录我按重要性排一下。 第一语义价值只看位置、不看朝向。同一个位置从背面可能因为遮挡而看不见论文目前只能靠小步走、从多个朝向观察来缓解。 第二方法上限受限于开源 VLM 的空间推理能力失败大多源于模型自己答错。作者也承认当前模型在不同场景之间的一致性还不够。 第三问题形式被限制在四选一。不足四个选项时要补一个占位选项比如D) 请不要选这一项。开放问答需要额外的候选生成步骤。 第四评测条件偏理想仿真假设完美里程计最大步数由场景二维面积开方乘三给定。真实部署里的定位漂移会直接吃掉探索预算。 作者给出的下一步包括用仿真场景或自我中心人类数据例如 Ego4D训练模型预测探索方向把多视角输入与检索引入推理以及把共形预测的预测集反过来用于引导探索——集合本身就给出了候选位置。 ## 常见问题FAQ ### 我要复现它大概需要什么资源 论文没有给出训练侧的资源明细因为主实验不训练 VLM。仿真实验在 Habitat 里跑 HM-EQA 的 500 个场景VLM 用的是开源的 Prismatic真机是单台 Fetch 加一部 iPhone 12。复现的主要成本在仿真渲染与推理侧的调用量。 ### 它和 KnowNo 有什么关系 同一批作者的前序工作是 KnowNo同样用共形预测校准大模型的不确定性。区别在判断对象KnowNo 判断规划器何时该向人类求助本文判断机器人何时该停止探索。 ### 它和 CLIP 类语义导航的区别在哪 CLIP-FBE 用 CLIP 给场景打分做语义权重论文方法则直接用 VLM 的概率输出。论文的观察是 CLIP 偏向词袋式匹配遇到走廊尽头那扇门后是什么这类需要推理的问题给出的信号会变弱。 ### 共形预测的覆盖保证在实际使用中怎么读 它保证的是以概率 $1-\epsilon$真实答案留在预测集交集里。这个说法依赖校准场景与测试场景同分布论文里用 300 个场景校准、200 个场景测试来满足这一点。 ### 为什么不用 GPT4-V 做实验 因为方法需要模型输出概率而当时可用的 GPT4-V 接口拿不到 log 概率。论文因此选了开源的 Prismatic附录里也提到官方版 GPT4-V 后来开放了 log 概率。 ## 最后一句 这篇论文最值得带走的一句话是具身探索的两个死结——记不住、停不准——可以用一张地图和一套校准解开而不必等一个更大的模型。如果你顺着这条线往下看建议优先读后续把记忆与信念建模引入 EQA 的工作例如 Memory-Centric EQA 与 Prune-Then-Plan它们处理的正是本文偏理想化的那部分假设。 ## 参考链接 - 论文 arXiv 主页https://arxiv.org/abs/2403.15941 - 项目主页与实验视频https://explore-eqa.github.io/ - EQA 起点工作 EmbodiedQADas et al., CVPR 2018https://arxiv.org/abs/1711.11543 - 共形预测入门Angelopoulos Bateshttps://arxiv.org/abs/2107.07511 - 前序工作 KnowNoRen et al., 2023https://arxiv.org/abs/2307.01928 --- 给大家推荐一款自用写文献综述、无虚构文献的 AI **复旦大学 FudanNLP 团队自研 [切问学术](https://qiewenpaper.com/zh?utm_sourcebzkolutm_contentbaishi)** 官网[qiewenpaper.com](https://qiewenpaper.com/zh?utm_sourcebzkolutm_contentbaishi) 覆盖 **3.6 亿篇**可溯源真实中英文文献能自动整合文献观点生成规范综述 还能挖掘研究创新点、复现实验配合视频教学新手快速上手文献综述写作 --- **后记** 博客的关键词集中在编程、算法、机器人、人工智能、数学等等持续高质量输出中。 **讨论QQ群**[白拾的小屋](https://qun.qq.com/universal-share/share?ac1authKeySuzrb5NKb9KulvZxFC8EMFvcd6jgVp%2B%2BnTG8h351HWQorXVfvI1n5QwEX5dlJyThbusi_dataeyJncm91cENvZGUiOiI3NTAzNjU3MDAiLCJ0b2tlbiI6IlpFL2xLaGYxdXU4cWJPT2dJTkY3aExnWHNaQ1UrL3NJbWprenhLZitWUHVVNmhIR1M5SkZrS09SWmxKNlRreksiLCJ1aW4iOiIyMjc1OTYwNDg2In0%3DdatahgymRnqgtjQPGoBKhZ8cEyznp0CMLWfCbG4rfiWIADCArVXw50a7c-Q4MWU2Eq3dwOUjG19hamAWQQU4lY-cOQsvctype4tempidh5_group_info) (750365700) **⭐B站账号**[白拾的物理AI组会](https://space.bilibili.com/98639326)活跃于知识区和动画区 **✨GitHub主页**[YhbCode000](https://github.com/yhbcode000)工程文件